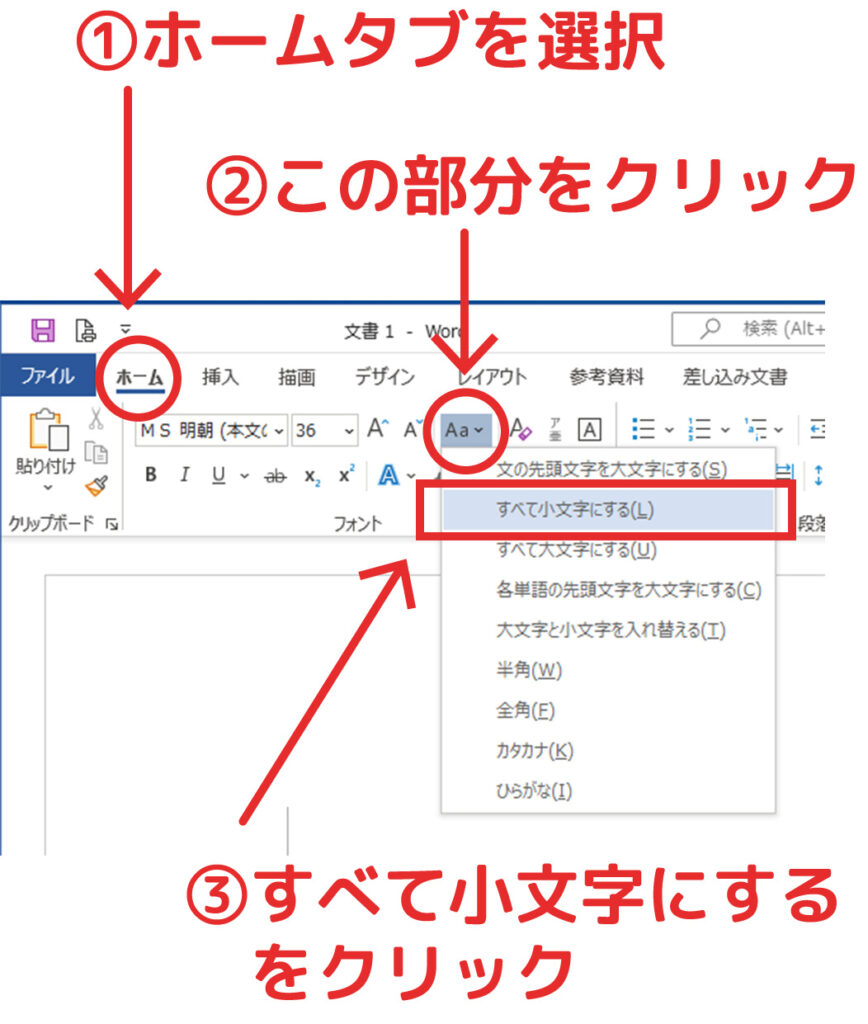
大文字・小文字の変換作業には、一見すると気付きにくい実務上の罠がいくつか潜んでいます。安易な一括処理でトラブルを引き起こさないために、以下のポイントを把握しておく必要があります。
1. 「全角アルファベット」が引き起こす変換エラー
日本国内の事務現場で最も頻発するトラブルが、全角半角英数変換の不備です。日本のレガシーな基幹システムから出力されたCSVデータには、全角文字の「abc」が混在しているケースが珍しくありません。
Excelの=UPPER("abc")関数を実行すると、出力結果は全角の大文字「ABC」になります。半角大文字を期待している外部APIやシステムにこの全角大文字を流し込むと、型不一致エラーや文字化けの原因になります。これを防ぐには、半角変換を行うASC関数と組み合わせて以下のように記述する必要があります。
=UPPER(ASC(A2))
この数式を組むことで、全角小文字であっても確実に「半角大文字」へと正規化されます。
2. CSSの「見た目変換」とデータコピーの乖離
CSSのtext-transform: uppercase;はあくまで視覚的なスタイリングに過ぎません。ユーザーがブラウザ画面上の大文字テキストをマウスでドラッグしてコピーし、メモ帳などにペーストした場合、クリップボードに入るのは元のHTMLに書かれていた小文字データになります。会員登録時の認証コード表示など、正確な文字列コピーが要求されるUIにおいて安易にCSS変換のみへ依存することは、ユーザー体験を損なう原因となるため注意が必要です。
3. 全て大文字にすることによる「可読性の低下」
タイポグラフィの視覚心理学において、長文のアルファベットをすべて大文字(All Caps)にすると、文字ごとの輪郭(アセンダーやディセンダーと呼ばれる突起部分)の差がなくなり、矩形に近いシルエットが続くため読字速度が約10〜15%低下することが知られています。強調したい見出しや型番、固有名詞に限定して大文字化を行い、説明文などの文章コンテンツには大文字の乱用を避けるのが情報設計の鉄則です。

