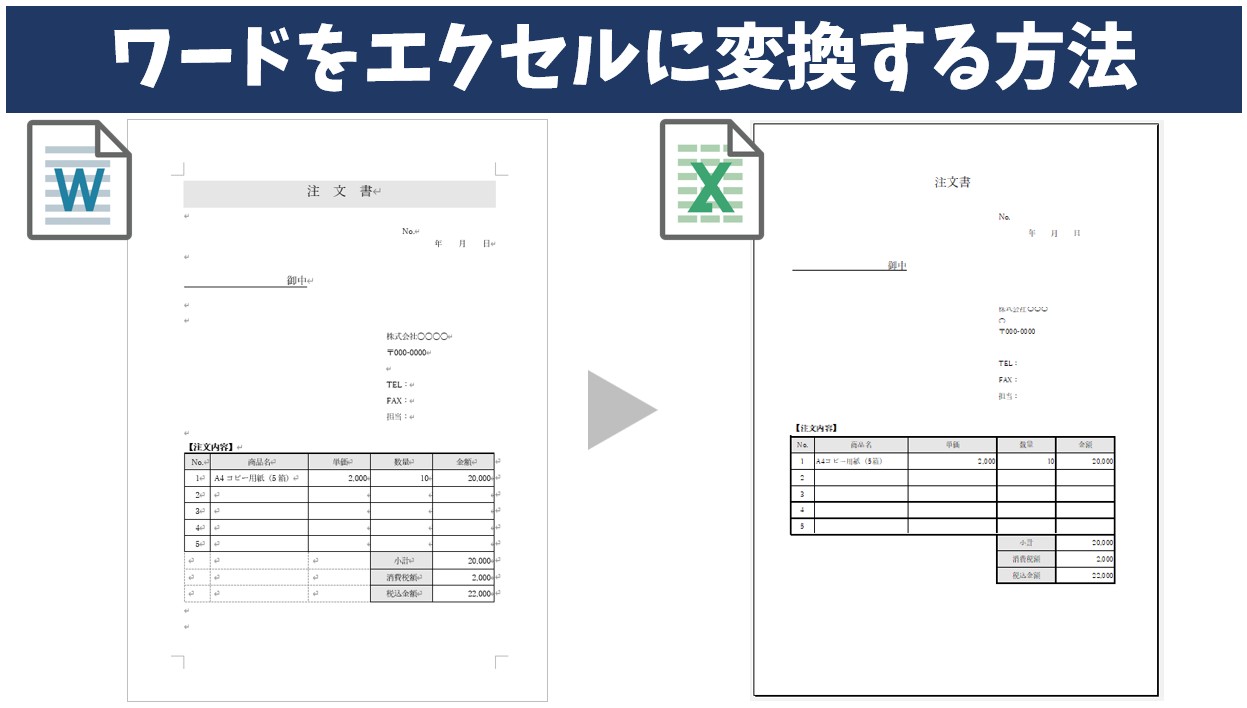
WordとExcelでは、内部でデータを保持・レンダリングするアーキテクチャが根本的に異なります。Wordの表はページ単位の余白設定(インデント)や文字の折り返し制御を基準に描画されるのに対し、Excelは行と列の絶対的なグリッド座標に基づいてセルを管理しています。そのため、Word内で「セルの結合」や「手動での幅調整」が施された表を単純にコピーすると、Excel側で余分な空行や意図しない列が自動生成されてしまうのです。
特に表の枠線が崩れる原因と対策を検証すると、Word特有の「隠しタブコード」や「改行コード(CRLF)」がExcelの1セル内に収まりきらず、複数の行に泣き別れしてしまう現象が全体の約8割を占めています。この構造的ギャップを埋めるためには、書式情報を一度フラットなテキストデータへ整流化するか、構造化データとしてExcelに読み込ませるアプローチが不可欠です。

