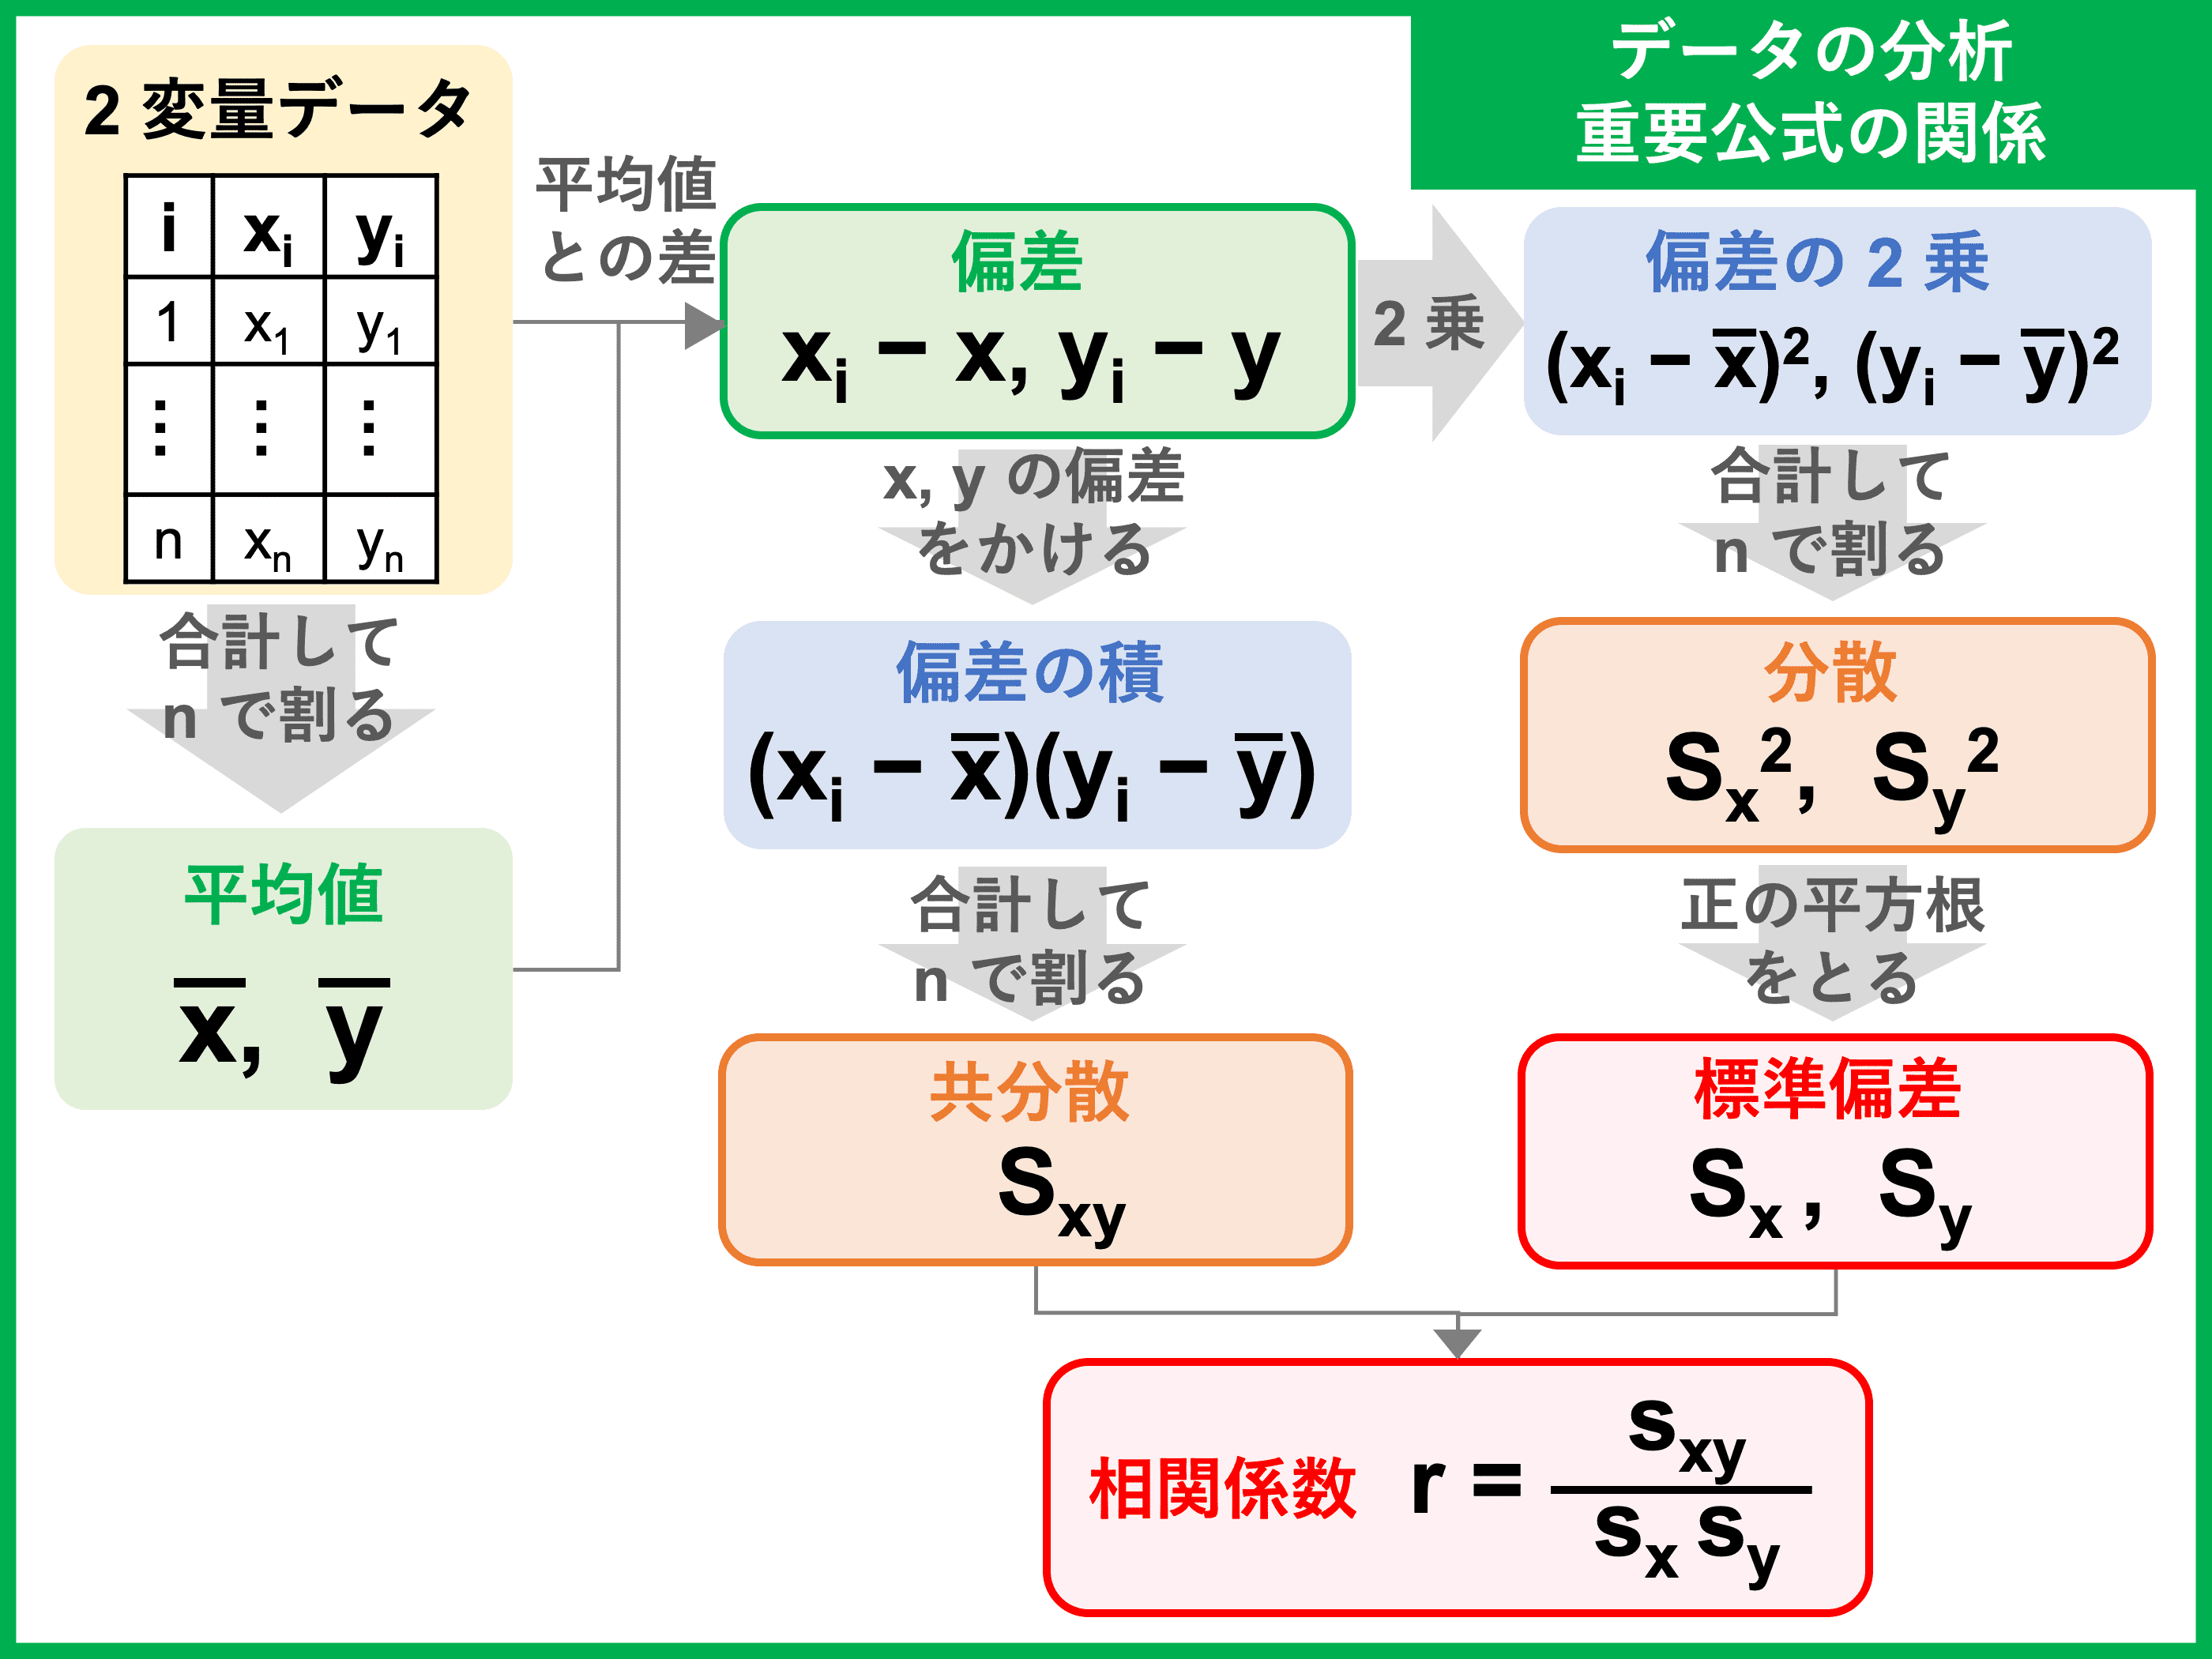
現場で日常的に使用される統計学公式一覧の中から、特に頻出するコアな数式とその設計思想を解き明かします。いずれもデータサイエンティスト必須数式として基礎研修で叩き込まれる重要項目です。
1. データの重心を見極める:平均値中央値最頻値使い分け
データを代表する1つの数値を決定する際、多くの人が無意識に平均値(算術平均)を用います。しかし、ここには実務上の大きな落とし穴が存在します。
・平均値(Mean): $\bar{x} = \frac{1}{n}\sum_{i=1}^n x_i$
全データを足してデータ数で割る最も一般的な指標。正規分布に近いデータには最適ですが、極端な外れ値に弱く、一部の富裕層や超高額取引によって数値全体が実態から大きく乖離します。
・中央値(Median): データを昇順に並べた際、ちょうど中央に位置する値。
外れ値の影響を一切受けないため、年収データ、顧客生涯価値(LTV)、滞在時間などのロングテールな分布を把握する際に必須となります。
・最頻値(Mode): 最も出現頻度が高い値。
アパレルの売れ筋サイズや靴のサイズ、アンケートの満足度評価など、離散的なカテゴリーの代表値を捉える際に機能します。
2. リスクとブレを可視化する:標準偏差計算公式
ビジネスにおいて「平均」と同じ、あるいはそれ以上に重要なのが「データのばらつき」です。それを定量化するのが標準偏差計算公式です。
標本分散: $s^2 = \frac{1}{n-1}\sum_{i=1}^n (x_i - \bar{x})^2$
標本標準偏差: $s = \sqrt{s^2} = \sqrt{\frac{1}{n-1}\sum_{i=1}^n (x_i - \bar{x})^2}$
各データから平均値を引いた「偏差」を二乗して合計し、自由度(n-1)で割って平方根を取ります。なぜ二乗するのかといえば、プラスとマイナスの偏差が相殺されてゼロになるのを防ぎ、かつ大きなブレに対してペナルティを与えるためです。標準偏差($\sigma$や$s$)を把握することで、「平均売上100万円・標準偏差10万円の安定店舗」と「平均売上100万円・標準偏差80万円のハイリスク店舗」を明確に峻別できるようになります。
3. 変数間の連動性を測る:相関係数求め方
2つの要素に関連があるかを探る指標が、ピアソンの積率相関係数です。相関係数求め方の基本式は、共分散をそれぞれの標準偏差の積で割る構造になっています。
相関係数: $r = \frac{s_{xy}}{s_x s_y} = \frac{\sum (x_i - \bar{x})(y_i - \bar{y})}{\sqrt{\sum (x_i - \bar{x})^2} \sqrt{\sum (y_i - \bar{y})^2}}$
値は必ず-1から+1の間に収まります。+1に近ければ「一方が増えればもう一方も増える(正の相関)」、-1に近ければ「一方が増えればもう一方は減る(負の相関)」、0付近は無相関を示します。広告費と獲得件数、Webサイトのスクロール深度と購買率など、施策の当たりをつける初動フェーズで多用されます。
4. 未来の数値を予測する:単回帰分析計算式
相関関係から一歩進み、「原因(説明変数 $x$)」から「結果(目的変数 $y$)」を予測する直線モデルを導くのが単回帰分析です。直線の式は $y = ax + b$ で表されますが、この傾き $a$ と切片 $b$ を求める単回帰分析計算式は最小二乗法によって次のように定義されます。
傾き: $a = \frac{s_{xy}}{s_x^2} = \frac{\sum (x_i - \bar{x})(y_i - \bar{y})}{\sum (x_i - \bar{x})^2}$
切片: $b = \bar{y} - a\bar{x}$
実績値と予測直線とのズレ(残差)の二乗和を最小化する計算式です。これにより、「広告出稿量を100万円増やしたとき、売上は何万円伸びるか」という限界効果を定量的にシミュレーション可能になります。
5. 偶然か必然かを判定する:仮説検定手順と分散分析計算手順
Webマーケティングの施策検証などで「バナーAとバナーBでCVRに差が出たが、これは単なる偶然のブレか、それとも施策の真の効果か」をジャッジするのが仮説検定手順です。
- 仮説の設定: 差がないとする「帰無仮説($H_0$)」と、差があるとする「対立仮説($H_1$)」を立てる。
- 有意水準の決定: 慣例として5%($\alpha = 0.05$)または1%に設定する。
- 検定統計量の算出: t検定の場合、サンプルサイズと標準誤差からt値を計算する。
- p値の判定: 算出されたp値が0.05を下回れば帰無仮説を棄却し、「統計的に有意な差がある」と結論づける。
また、3群以上の平均値の差を比較する場合、t検定を繰り返すと第一種の過誤(偽陽性)が跳ね上がるため、分散分析計算手順(ANOVA)を用います。「全体のばらつき」を「グループ間のばらつき(施策効果)」と「グループ内のばらつき(ノイズ)」に分解し、F比(群間平方和/群内平方和)を導き出して有意差を検定します。

