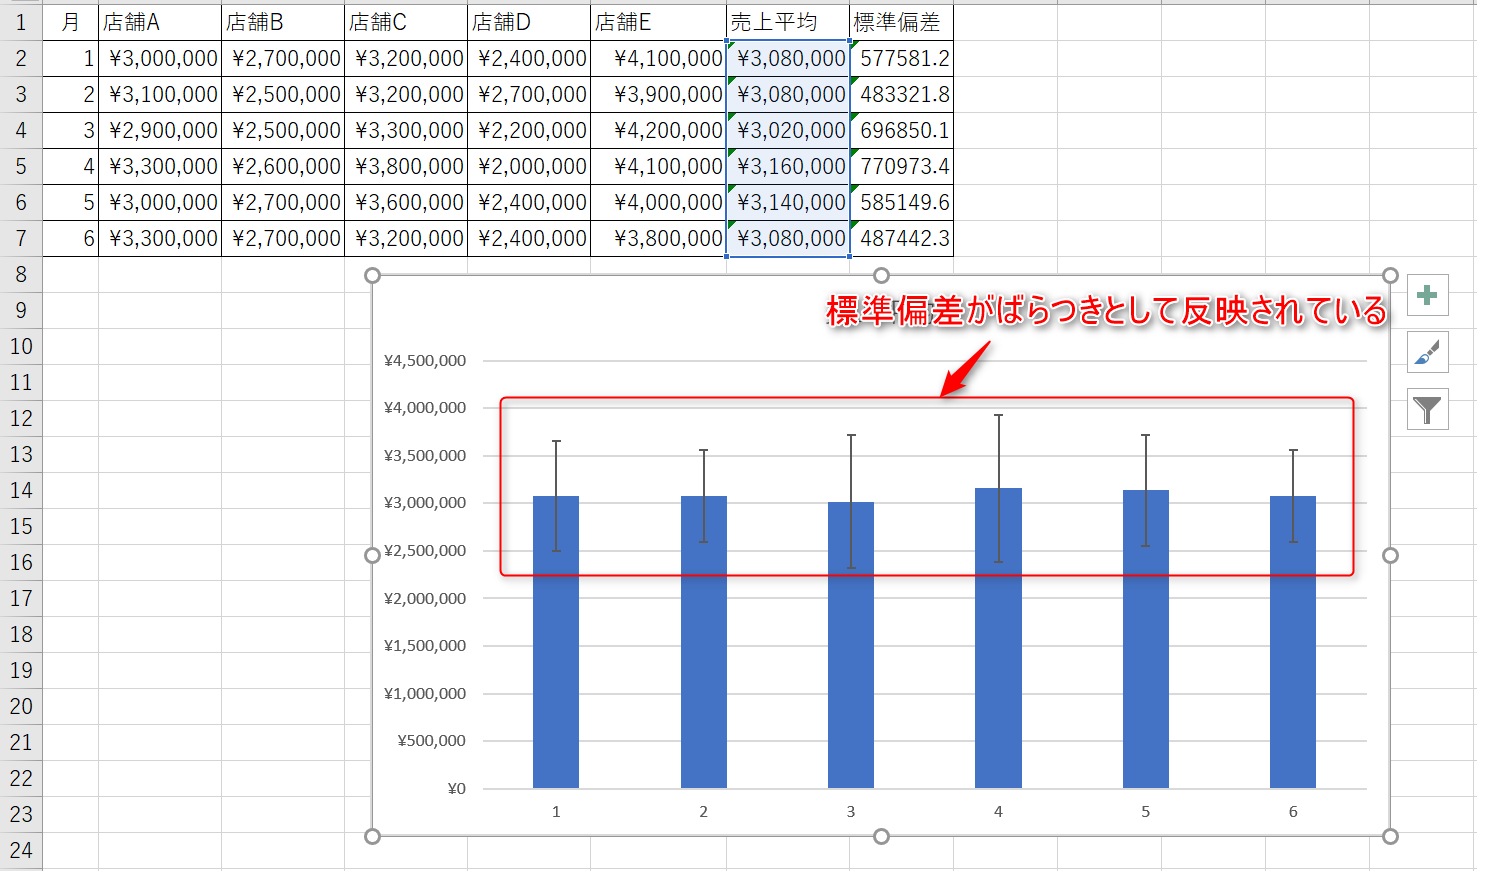
最新のエクセル環境では、動的配列数式(スピル)やCopilotをはじめとするAI機能の統合により、データ処理のワークフローが根本から変化しています。標準偏差の算出においても、手作業で数式を細かく打ち込む時代から、大規模データを瞬時に構造化して分析するアプローチへと移行しつつあります。
例えば、FILTER関数とSTDEV.Sを組み合わせることで、「特定の部署かつ勤続3年以上の社員」といった複雑な条件付き標準偏差の算出が、作業列を一切作らずに1行の数式で完結します。
=STDEV.S(FILTER(C2:C100, (A2:A100="営業部") * (B2:B100>=3)))
【プロの結論】標準偏差を活用すべき場面・避けるべき場面の判断基準
データ分析において標準偏差は強力な武器ですが、万能ではありません。実務における明瞭な採用基準を持っておくことが不可欠です。
- 標準偏差が極めて有効なケース:
- テストの点数、製造ラインの製品寸法、社員の身長など、データが左右対称の「正規分布」に近い形状を示す場合。
- 平均値だけでは見抜けない「リスクの大きさ(ばらつき)」を定量比較したい場合。
- 標準偏差の使用を避けるべき(慎重になるべき)ケース:
- 年収データ、Webサイトの滞在時間、アプリの課金額など、一部の極端な外れ値によってグラフの裾野が極端に右へ伸びる「歪んだ分布」の場合。
- このようなケースでは、平均値と標準偏差ではなく、「中央値(MEDIAN)」と「四分位範囲(IQR)」を用いた方が実態を正確に把握できます。

