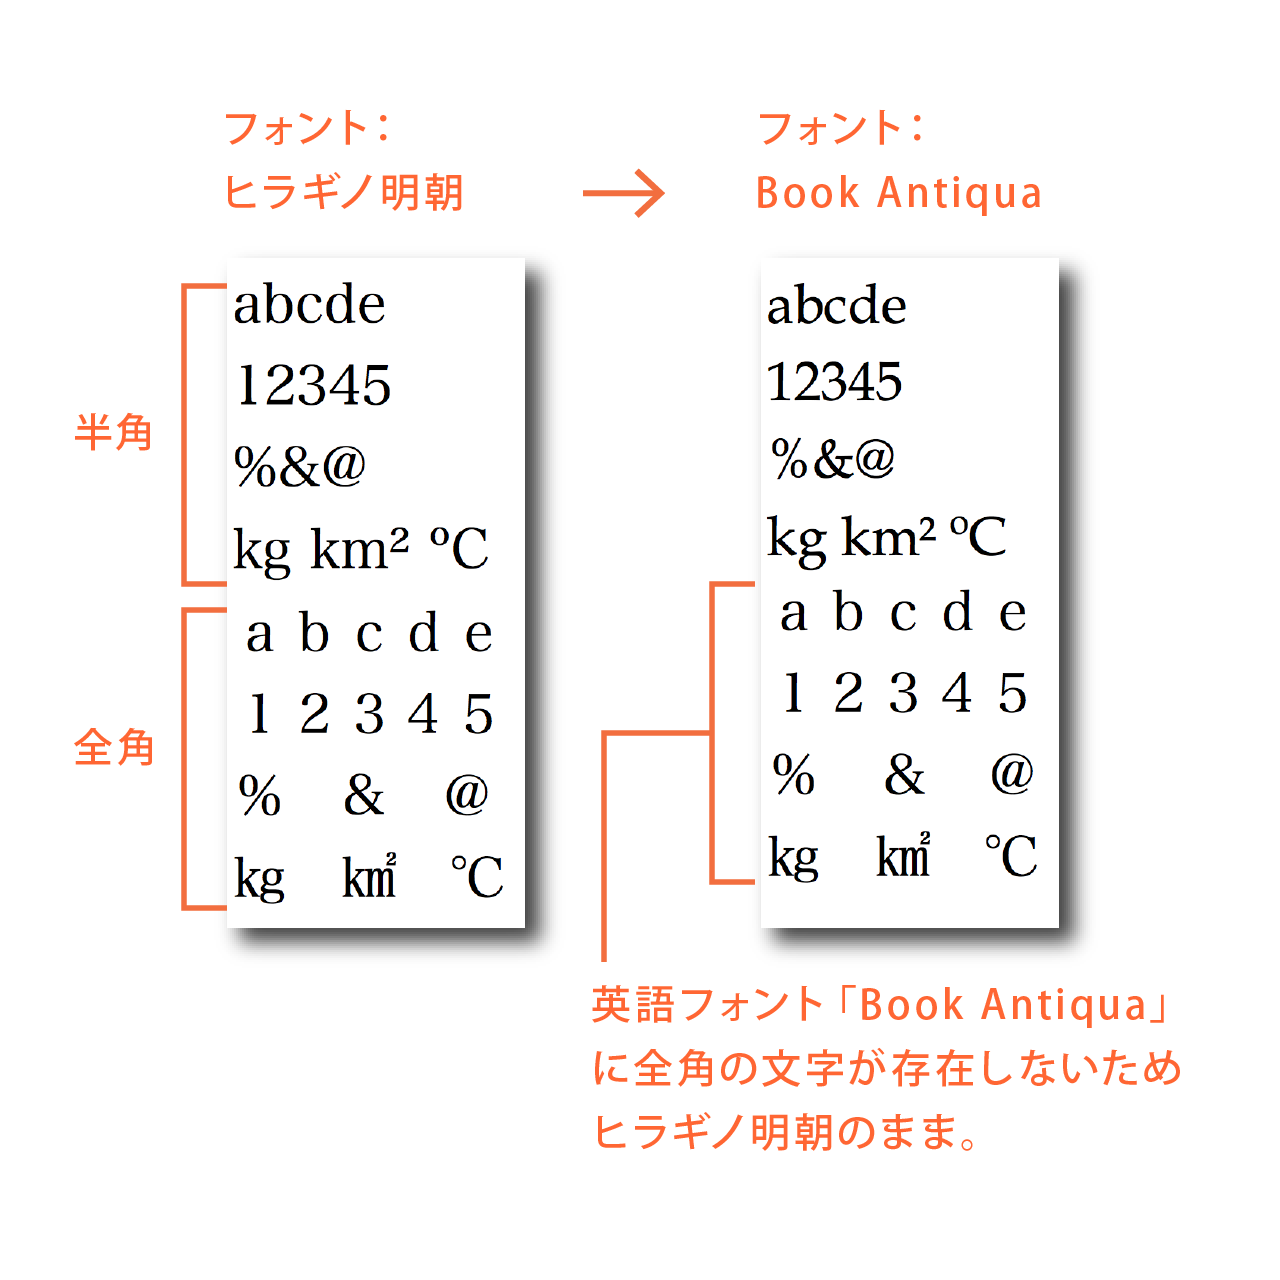
全角文字(ぜんかくもじ)とは、文字の縦と横の比率が「1対1」の正方形のマス目の中にデザインされた文字の総称です。英語圏のタイポグラフィにおける「em(エム)」の概念に由来し、活版印刷の時代にMの活字が持つ正方形のボディサイズを基準としていた名残を受け継いでいます。一方の半角文字は、全角の半分の幅(縦2対横1の長方形)で作られた文字を指します。
コンピュータの黎明期において、アルファベットや数字、基本的な記号は1バイト(8ビット=256通り)のデータ領域で管理される「ASCII(アスキー)コード」で表現されていました。これが半角文字の原型です。しかし、数千種類に及ぶ漢字やひらがなを扱う日本語環境では、わずか256通りの枠には到底収まりません。そこで開発されたのが、2つのバイト(16ビット=約6万5千通り)を組み合わせて1文字を表す2バイト文字の仕組みです。
国内の標準規格であるJIS規格Unicode全角の体系では、日本語の文章を構成するすべての文字要素に全角のコードが割り当てられています。ここで、日常的に使用される代表的な全角文字の構成を整理しておきましょう。
【代表的な全角文字一覧】
- 和文文字:ひらがな(あ、い、う…)、全角カタカナ(ア、イ、ウ…)、漢字(亜、哀、愛…)
- 全角英数字:A、B、C…、a、b、c…、0、1、2…
- 全角記号・約物:!、?、@、#、¥、%、&、*、全角スペース( )
- 全角特殊文字:★、◆、〒、♪、※、―(ダッシュ)
アルファベットや数字、記号には「全角」と「半角」の両方が存在します。見た目は似ていても、コンピュータ内部では「まったく異なる背番号(文字コード)」が割り振られた別個のデータとして処理される点が、あらゆるトラブルの根本原因となっています。

