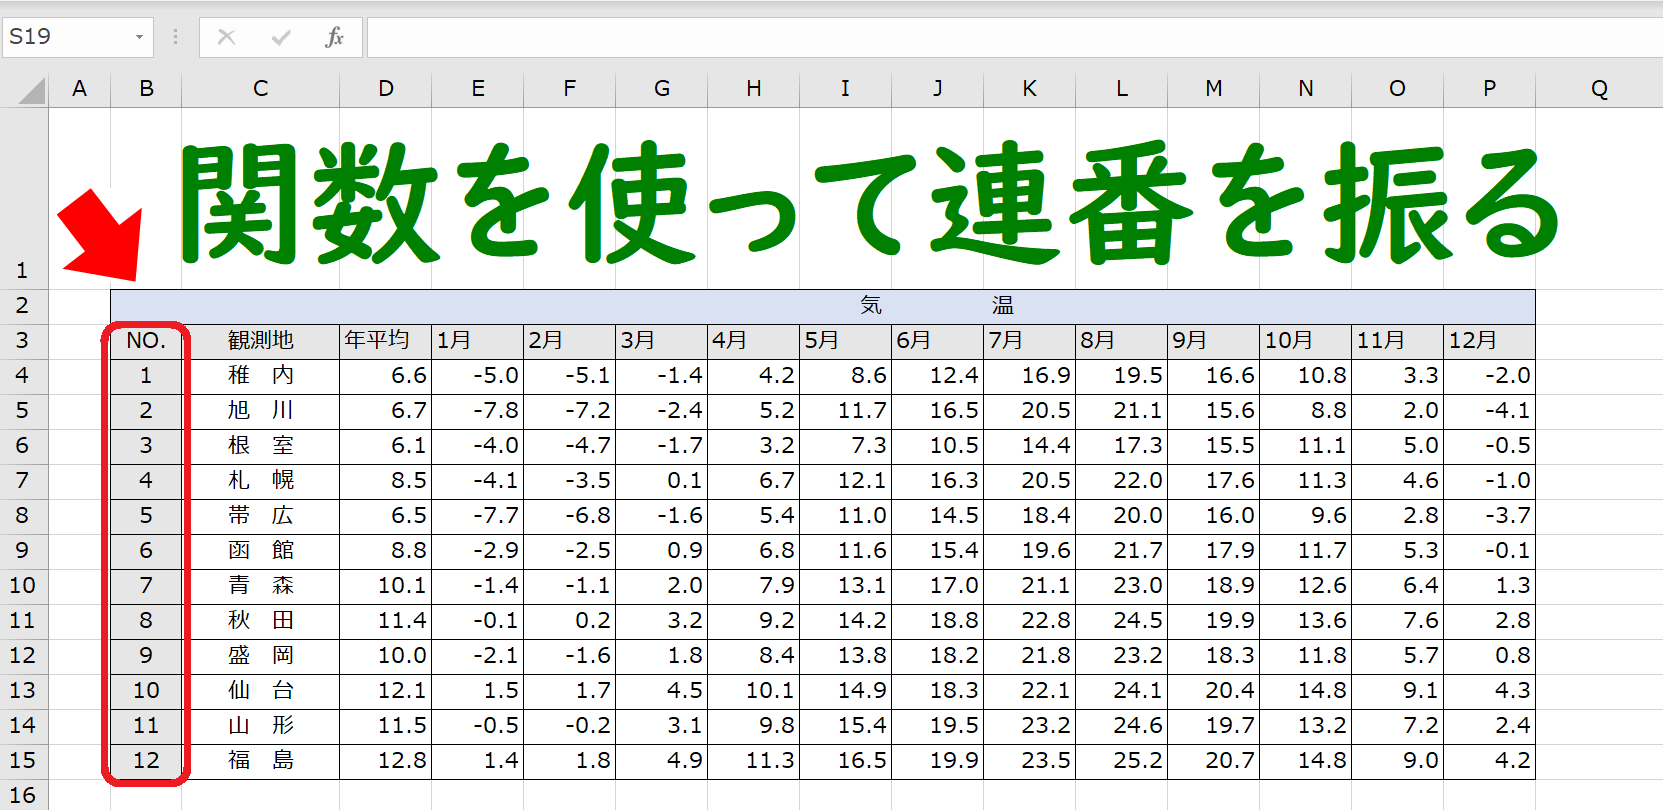
インターネット上のノウハウ記事では「連番はすべてROW関数を使えば解決する」と一律に推奨される傾向がありますが、ここには実務上の重大な盲点が存在します。
第一の誤解は、「データの固有ID(識別子)」と「表示上の行位置(通し番号)」の混同です。ROW関数やSEQUENCE関数が返しているのは、あくまで「その行が上から何番目に位置しているか」という相対的な画面上の位置情報に過ぎません。そのため、並び替え(ソート)を実行したり途中の行を削除したりすると、特定の顧客データに紐づいていたはずの番号が自動的に書き換わってしまいます。顧客IDや伝票番号のように「絶対に変動してはならない識別キー」には、関数による動的連番ではなく、採番時に確定させた固有値を入力しなければなりません。
第二の盲点は、極めて大規模なデータセットにおける計算負荷です。数十万行に及ぶ巨大シートでSUBTOTALやCOUNTIFを用いた累積計算を全行に設定すると、セルの再計算コストが跳ね上がり、ブックの動作が著しく重くなる原因となります。大量データを処理する場合は、SEQUENCE関数による一括配列展開を用いるか、Power Query(パワークエリ)の「インデックス列の追加」機能を用いてデータロード時に連番を付与するのが、現代のエンジニアリング視点における最適なアプローチです。

