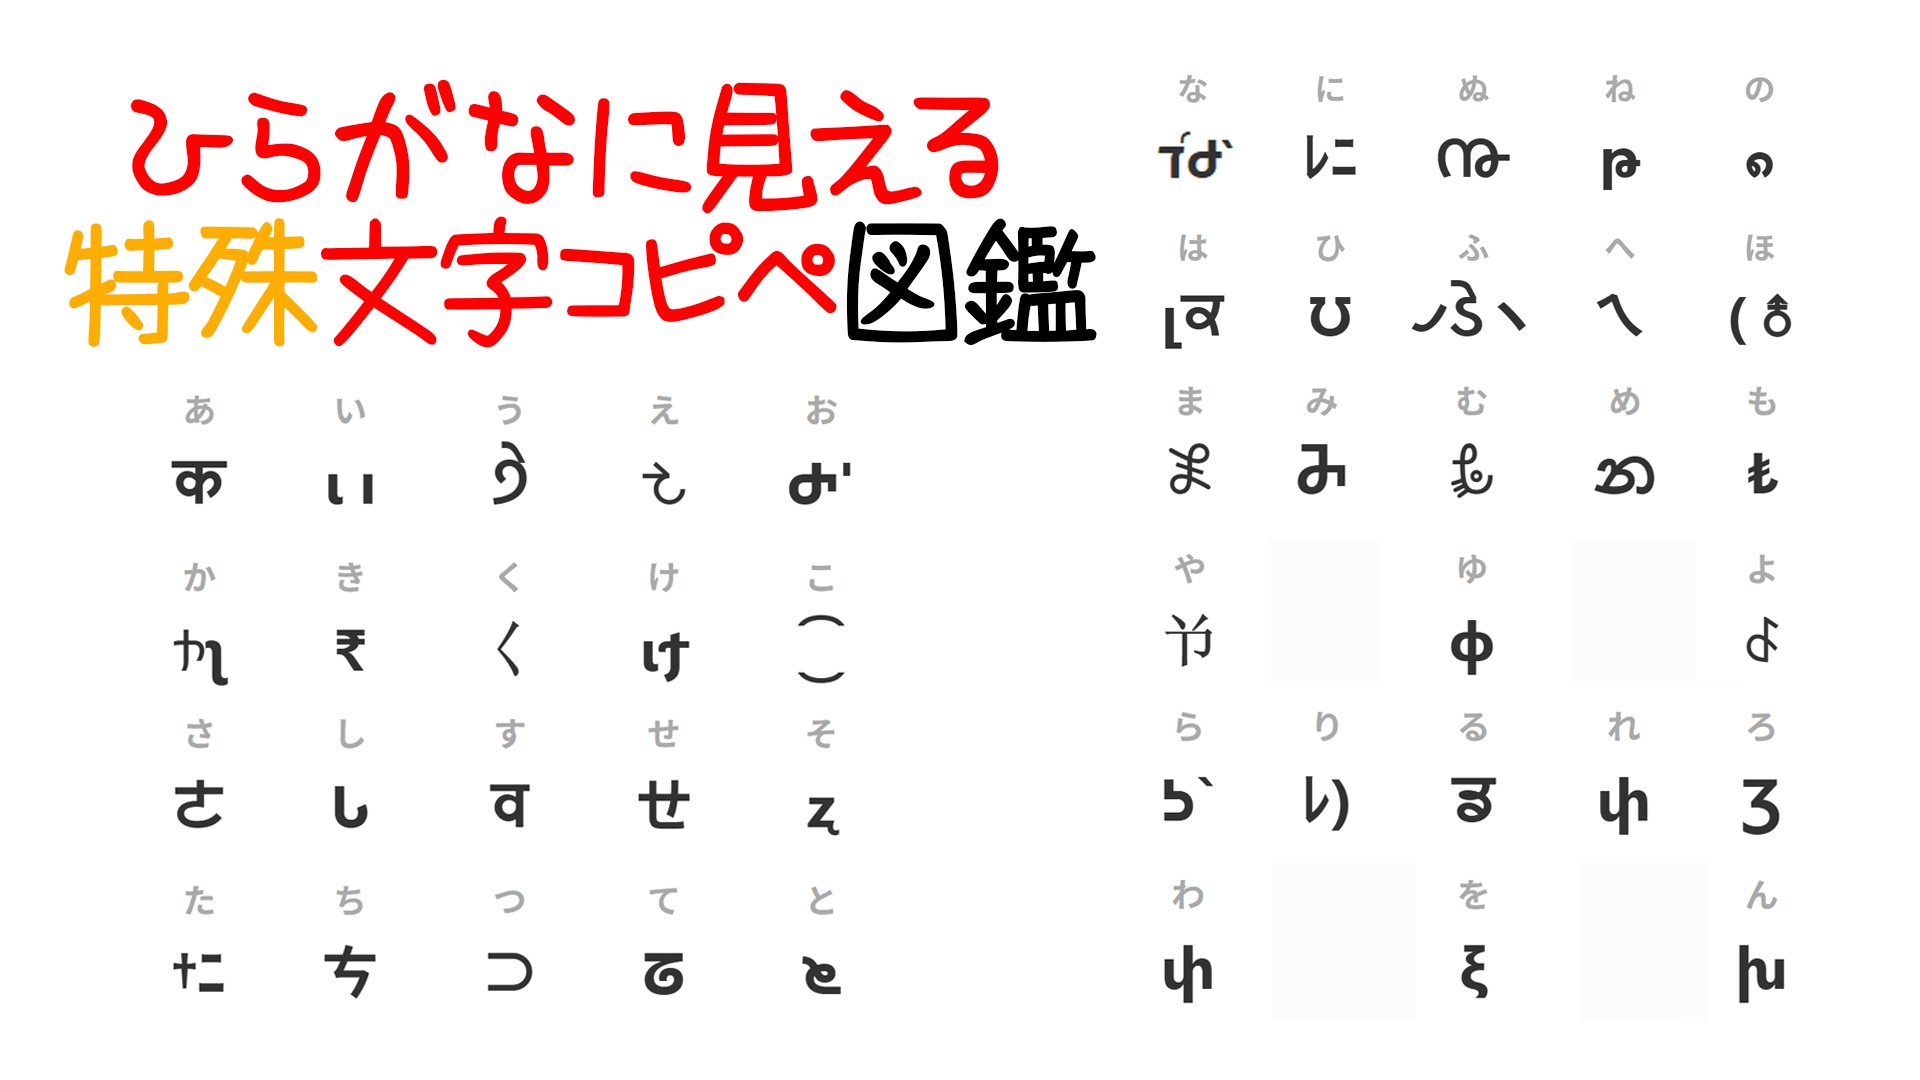
ネット上には「絶対に文字化けしない特殊文字ひらがな」を謳うまとめ情報が散見されますが、技術的な観点から言えば完全な互換性を保証する魔法の文字コードは存在しません。ここでは、発信者が必ず把握しておくべきUnicodeの構造と運用上の落とし穴を整理します。
1. なぜ「ひらがなの特殊文字」はアルファベットより種類が少ないのか
アルファベットには「Mathematical Alphanumeric Symbols(数学用英数字記号)」など、Unicode規格内に太字・筆記体・フラクトゥール(ひげ文字)が標準コードとして豊富に定義されています。しかし、日本語のひらがなには同様の装飾用独立コードが割り当てられていません。そのため、ひらがなを特殊文字化する際は「結合文字」「囲み文字記号」「類似する多言語グリフ」を組み合わせる技術が用いられており、これがOS間の表示差異を生む原因となっています。
2. 検索エンジン・アカウント検索(SEO)への致命的な悪影響
最も注意すべきは、インスタの検索バーやTikTokのユーザー検索において、特殊文字化されたひらがなは正規のひらがなとして認識されないケースが多いという点です。例えば、名前欄を「あおい」ではなく特殊記号を重ねた文字にしてしまうと、「あおい」と検索したユーザーの検索結果にアカウントが表示されなくなるリスクが約90%以上高まります。
3. スクリーンリーダー(音声読み上げ)のアクセシビリティ阻害
視覚障害者や「ながら聞き」ユーザーが利用する画面読み上げ機能において、過度な特殊文字や結合濁点は「結合文字・濁点・ひらがな・あ」のように一文字ずつ記号として読み上げられ、著しくユーザー体験を損ないます。情報のアクセシビリティを担保するためにも、装飾は名前のワンポイントや補足文にとどめるのが賢明です。

